
Embedding: AI如何把世界变成一张数字地图
1. Embedding 的定义
Embedding 就是把现实中的东西——一个词、一句话、一张图、一段代码去映射成一串固定长度的向量。
例如:“猫”。 经过 Embedding 模型之后,可能变成:
[0.231,-0.452,0.781,...0.125]这就是一个向量。但是这里有一个关键问题: 这些数字看起来毫无意义。
为什么:
猫 → [0.23, -0.45, 0.78...]

狗 → [0.21, -0.41, 0.76...]

汽车 → [-0.72, 0.15, -0.33...]模型却可以知道:猫 和 狗 更接近,猫 和 汽车 更远?
其原因在于:
Embedding模型通过训练目标,让具有相似含义的信息,在向量空间中形成相近的位置关系。
注意:
Embedding不是人为规定:“第1个数字代表动物性,第2个数字代表大小。”这些维度没有明确的人类含义。它更像是一张由模型自己绘制出来的“语义地图”。
1.1 用一张地图理解Embedding
假设我们把全世界的餐厅放进一个二维地图:
在这个地图中:
- 火锅店距离麻辣烫很近
- 咖啡馆距离甜品店较近
- 火锅店距离咖啡馆较远
那么:(x,y)这个坐标,就可以看作这家店的 Embedding。但是现实中的 Embedding 不是二维,而是:768维、1536维、3072维、...、n维。
人类无法直接观察这些高维空间,所以通常会使用:PCA、t-SNE、UMAP 等降维方法将其压缩到二维或者三维进行可视化。
最终你可能看到类似:
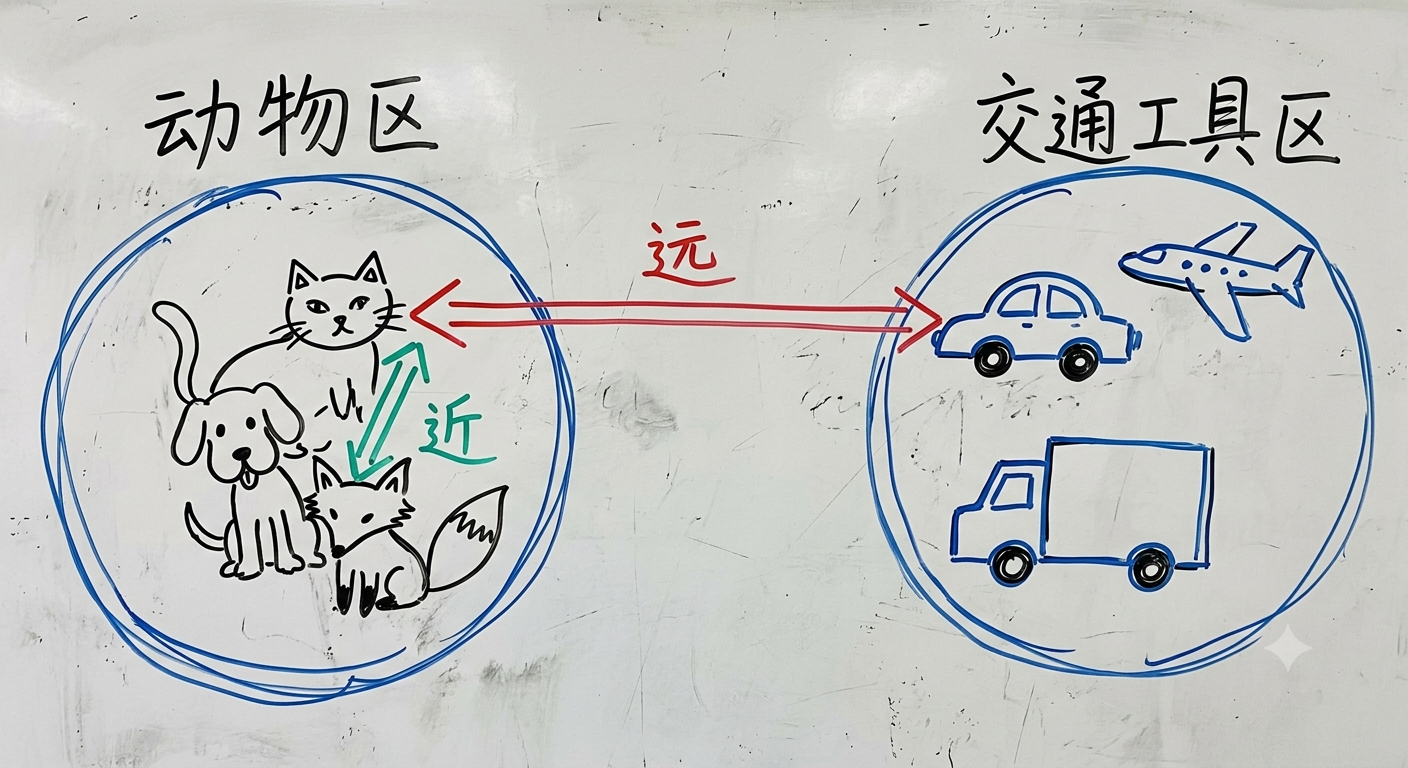
这就是 Embedding 的核心思想:
把无法直接比较的概念,转换成可以计算距离的数字空间。
1.2 Embedding不是身份证,而是语义坐标
很多人第一次理解 Embedding 时,会认为:
“是不是给每个东西分配一个数字编号?”
比如:
猫 = 10001
狗 = 10002
汽车 = 10003这其实是错误的。这种编号叫 ID:它只表示唯一身份,并不包含任何关系。从数字上看:猫距离狗 = 1,猫距离汽车 = 2。但是这个距离没有任何意义。
Embedding 不同,它更像:猫: [动物属性,可爱程度,行为模式,生活环境,...]
这些信息被压缩成一个高维数字表示。所以:语义相似的东西,通常在空间中更加接近。 数学上,可以表示为:
Embedding(输入)
其中:
- d 表示向量维度
- R^d 表示 d 维实数空间
例如:Embedding("猫") → [0.231,-0.452,0.781,...]。 得到向量后,计算机就可以通过数学方法比较它们之间的关系。
例如:
- 余弦相似度
- 欧氏距离
2. 为什么非要用 Embedding 不可?
2.1 计算机只懂得数字,不懂得“意思”
计算机底层只能处理数字。如果输入:“猫”。 对于计算机来说,它并不知道:猫是一种动物,会叫,可以作为宠物。它看到的只是字符。
最早的方法之一是:进行 One-Hot 编码,假设词表有10万个词: 猫 [0,0,0,0,1,0,0,...]。只有对应位置是1,其余都是0。
这样就有一个致命缺陷:
- 高维稀疏:如果维度升高至10w维度,会造成维度爆炸和数据稀疏。里面几乎都是0。
- 无法表达语义关系:“猫”可能和“核聚变”是相近的意思。
2.2 人类语言的本质就是稠密、连续的关系
但是人类理解世界不是这样的。我们的大脑天然会建立:
猫
↓
动物
↓
宠物
↓
可爱这样的关联网络。
Embedding 就是尝试把这种关联关系转换成数学空间。
3. 这些Embedding向量是怎么产生的?
前面我们知道:Embedding可以把一个概念转换成一个数字向量。 但是还有一个问题:这些数字到底是谁决定的?
为什么:猫: [0.23,0.54,-0.12...]。而不是,猫: [0.91,-0.32,0.44...]
答案是:
Embedding不是人工设计出来的,而是模型在大量数据和训练任务中,通过不断调整参数自动学习出来的。
简单来说:模型并不知道:“猫应该放在哪里。” 它只是不断完成任务:
预测
↓
犯错
↓
调整参数
↓
继续预测
↓
形成更好的表示经过大量训练后,模型内部逐渐形成了一套数字空间。
3.1 核心思想:一个词的含义来自它出现的环境
在语言学中有一个著名的 分布假说:
一个词的含义,可以通过它经常和哪些词一起出现来推测。
比如,“猫”经常和“喵”、“撸”、“宠物”等一起出现,而“核聚变”的邻居是“等离子体”等词汇。
如果一个模型阅读了大量文本,它会发现:
“猫”和“宠物”的上下文模式很接近。 “核聚变”和“等离子体”的上下文模式很接近。
于是,这些词在向量空间中逐渐靠近。这就是Embedding形成的基础。
3.2 Word2Vec: 猜词游戏里的副产品
2013年,Mikolov等人提出 Word2Vec,它的核心思想非常简单:让计算机玩一个“猜词游戏”。 在训练过程中,它不断尝试根据上下文预测目标词。
Word2Vec主要有两种方式:
- CBOW(连续词袋模型):通过周围的词预测中间的词。输入“我爱_苹果”,让模型预测中间词是“吃”。如果预测错误,调整模型参数,并不断进行重复。
- Skip-gram:刚好相反,通过一个词预测附近出现的词。看到“吃”,让它猜旁边可能是“饭”、“苹果”。如果预测错误,也调整模型参数,并不断进行重复。
3.3 为什么“猜词”最后会得到语义?
这里是Embedding最神奇的地方。训练目标看起来只是猜下一个词,但是为了猜得更准确,模型必须学习哪些词经常一起出现。
例如: 如果模型想预测:我喜欢吃___,它必须知道:苹果、香蕉、面包这些词,比汽车、电脑、火箭,更可能出现。
为了完成预测任务,模型被迫在隐藏层中保存:
- 词之间的关系
- 使用场景
- 语义关联
最终,隐藏层中的参数,就成为了Embedding。
所以:
Embedding不是训练目标本身,而是模型为了完成任务而产生的内部表示。
这也是为什么经常说:Embedding是预测任务的“副产品”。
4. 现代LLM内部的Embedding是如何工作的?
在Word2Vec时代,一个词对应一个固定向量。例如:苹果 ➡ [0.21,0.43,0.55...]。无论在哪里出现,都是同一个向量。这种叫静态Embedding。
但是其语言存在歧义,例如:我喜欢吃苹果(这里的苹果是水果);我买了一部苹果手机(这里的苹果是手机品牌)。如果两个场景使用同一个向量,会导致模型无法区分。
所以现代LLM引入了上下文Embedding,英文叫做 Contextual Embedding。同一个词,根据上下文产生不同表示。
4.1 从文字到向量:LLM输入流程
当你向大模型输入一句话,如:
请用中文解释光合作用在模型“理解”这句话之前,它会经历一个严格的 Embedding 流水线,这个过程不是用一个现成的向量表去查整句,而是分步完成的:
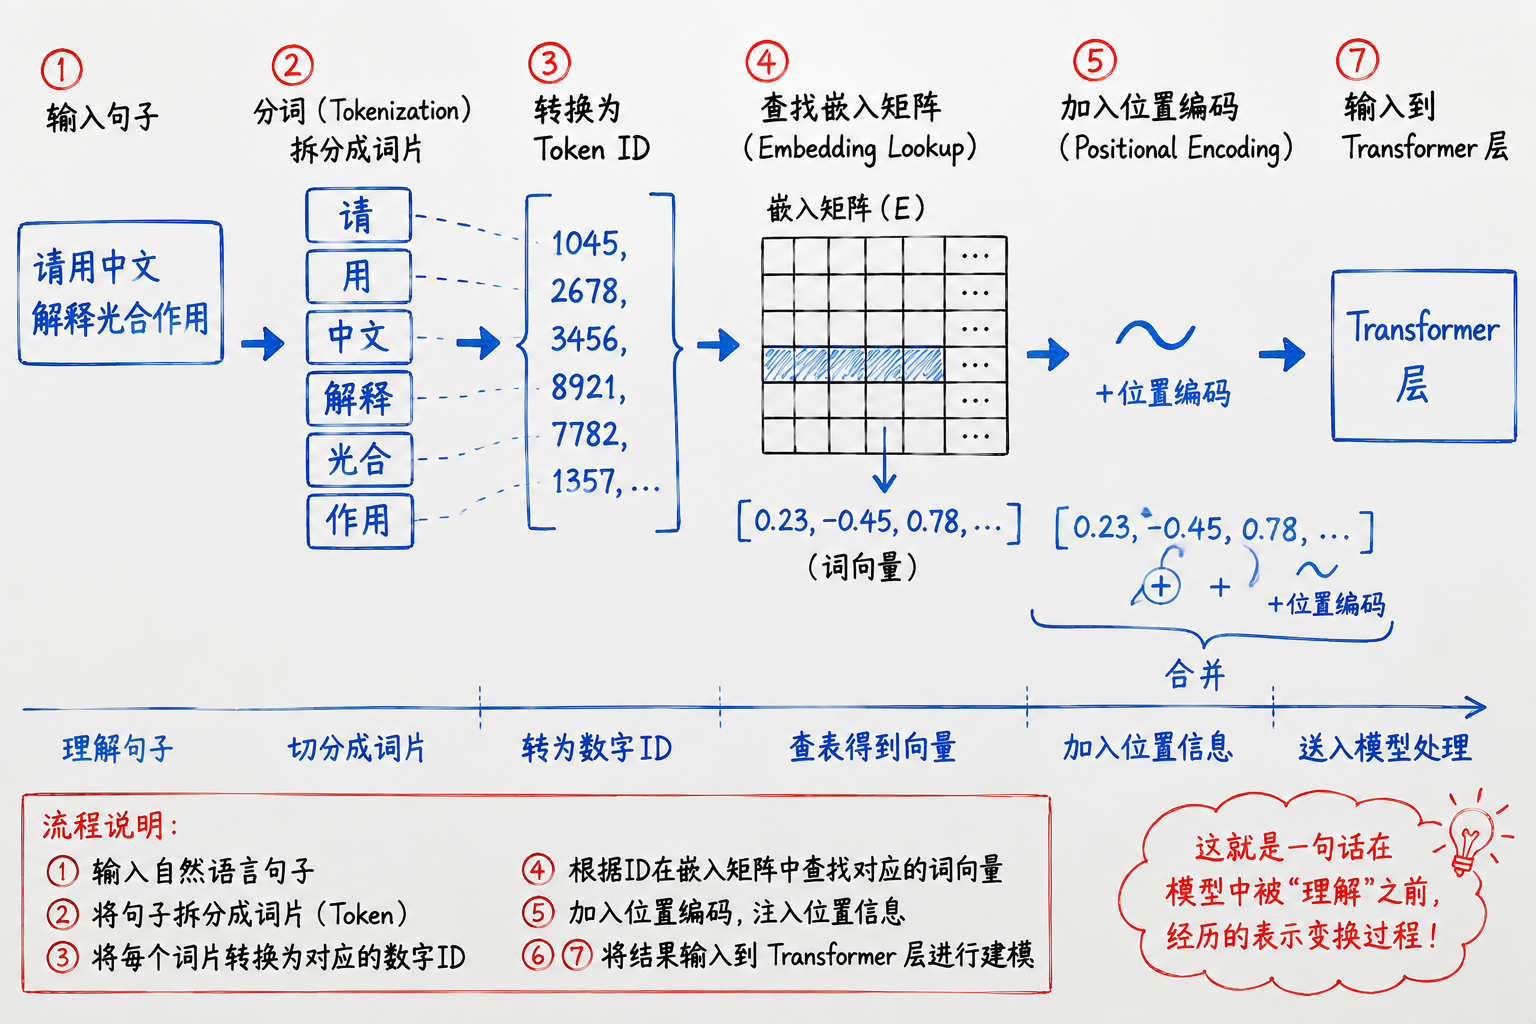
- 分词 句子首先被切成一串token。可能是整词、子词或者标点。比如BPE分词器会把这句话切分成类似
[“请”, “用”, “中文”, “解释”, “光合”, “作用”] 的序列。
这一步做的是:将自然语言编程模型词汇表中的编号序列。
Token ID 映射 每个 token 在词汇表中都有一个唯一的整数 ID,于是句子成了一个整数列表。此时计算机依然“不明白”任何意思。
Embedding层查表 LLM内部有一个巨大的
嵌入矩阵,每一行对应词汇表里一个token的稠密向量。根据token ID,从矩阵取出对应的向量,得到一个向量序列。 到此:每个token都独立拥有一个初始向量,但是这个向量还没有 语境信息——它只代表这个token的“基本义原型”。注入位置编码
为了让模型知道token的顺序(例如“不/好”与“好/不”),会把位置编码加到token向量上。这样就得到了带有位置信息的最终输入表示。
- 进入Transformer层 这组向量随后穿过多层自注意力机制,每一层都在与其他token交互,持续更新每个位置的向量,直到最后一个隐藏层的输出成为上下文相关的表示——
语境化Embedding。 “苹果”在“吃苹果”和“苹果手机”里,到这一步已经是完全不同的向量。
5. 大模型问答阶段:Embedding的角色
在纯粹的文本生成问答里,Embedding是 输入端和中间表示的核心,但通常不直接暴露给开发者。
- 用户的提问被
Embedding后,经过多层Transformer计算,最终在输出端预测下一个token。 - 整个模型内部没有显示“检索”外部知识。答案都压缩在参数里。这时
Embedding是一种隐式的语义计算载体,让模型能区别词语、理解上下文。
在这种模式下,Embedding 就是模型的一部分,但是由此带来的局限也很明显:知识截止于训练实践,无法访问私有文档。所以就需要外挂大脑——RAG来实现知识库查询。
6. Agent 与 RAG 层面的 Embedding:外挂大脑的实现
为了让智能体回答得有时效、能读取企业内部文档,现代 Agent 普遍采用 RAG(检索增强生成) 架构。这里的 Embedding 就上升为 连接用户意图与外部知识的桥梁。
6.1 RAG的Embedding流程
它与LLM内部Embedding最大的不同在于:使用独立的、专为语义相似度优化的嵌入模型。
具体流程:
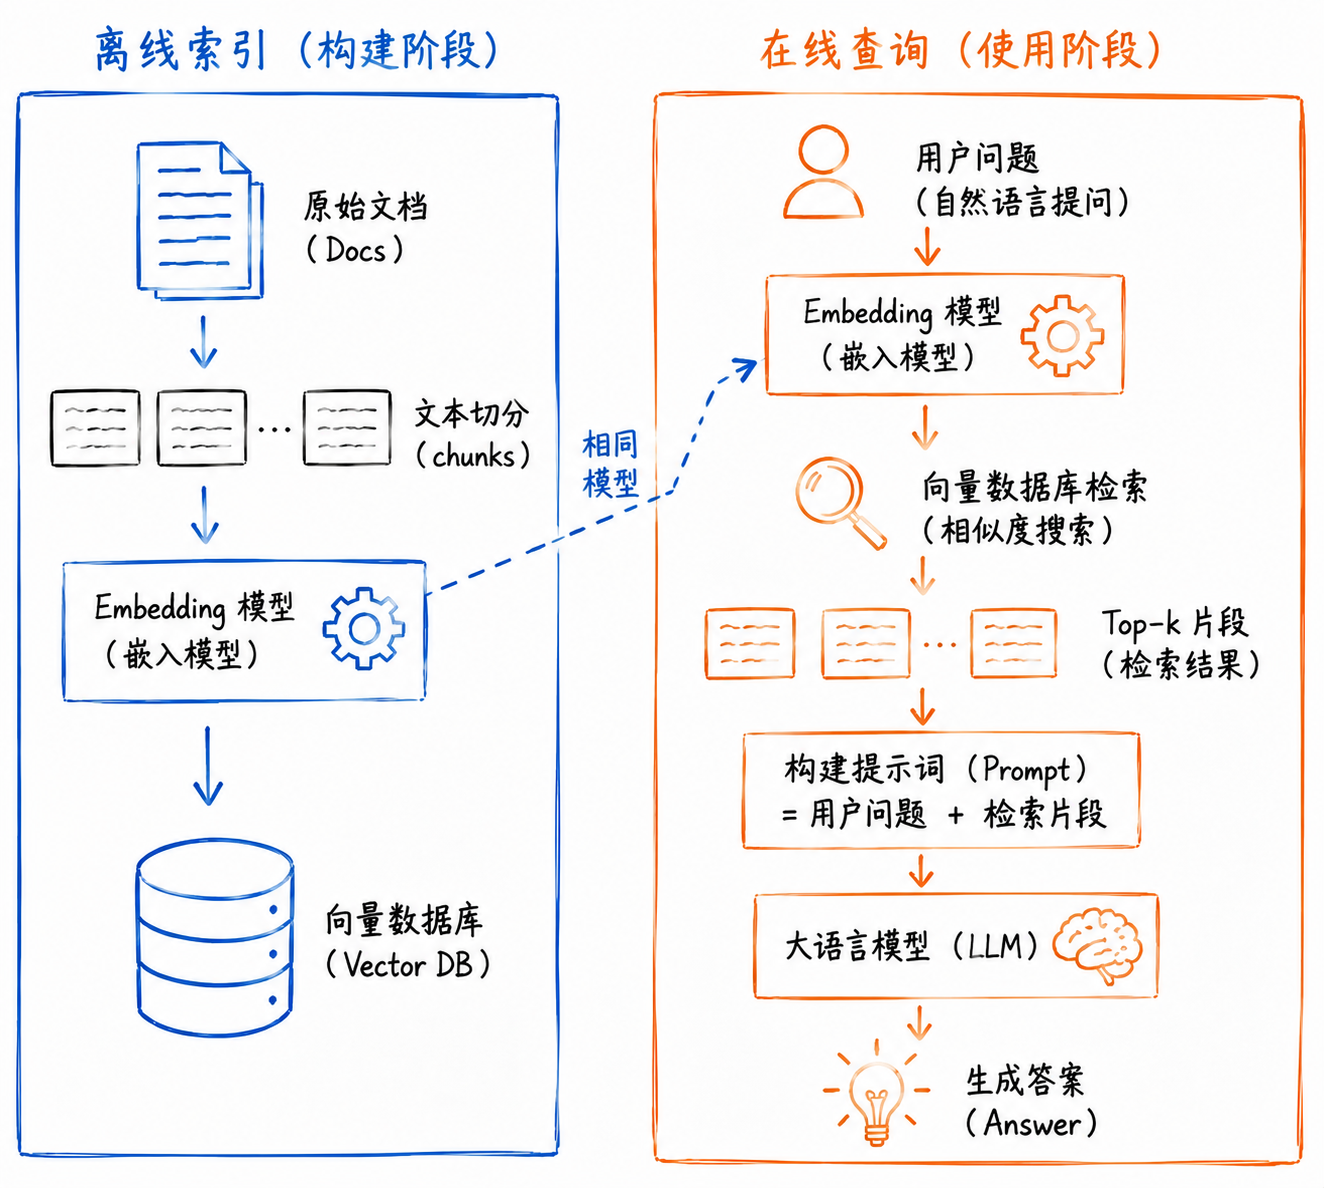
- 知识入库(离线阶段)
- 把私有文档、政策、手册等切成适当大小的文本块。
- 使用专门的 文本嵌入模型,将每个文本块编程成一个固定长度的向量。
- 把这些向量连同原始文本块一起存入
向量数据库。
- 检索(在线阶段)
- 用户提问同样被
同一个嵌入模型编码成查询向量。 - 用余弦相似度,在向量库中召回 top-k 个最接近的文本块。
- 增强生成
- 将检索到的文本块作为“参考资料”,拼接到提示词中,送给大模型。
- LLM阅读这些外部信息,生成可靠答案。
注意:这里的 Embedding 模型与LLM内部的嵌入层是两套不同的参数。前者追求“语义相近则向量相近”,后者追求“为下一个词预测保留足够语境”。
6.2 常用的 Embedding 方法
如果从“为用户输入生成一个向量表示”这个功能出发,我们可以将 Embedding 方法按两个维度来划分。
按粒度划分
| 类型 | 代表方法 | 说明 |
|---|---|---|
| 词级 Embedding | Word2Vec, GloVe | 一个词一个固定向量。轻量,但无法区分多义词,现代 LLM 中已很少独立使用。 |
| 句级 / 文档级 Embedding | Sentence‑BERT, SimCSE, OpenAI text‑embedding‑3, BGE, E5 | 将任意长度文本映射为一个固定向量,是目前 RAG 的主力模型。 |
| 跨模态 Embedding | CLIP | 把文本和图像映射到同一空间,实现图文互搜。 |
按是否感知上下文划分
静态 Embedding(Word2Vec, GloVe):训练结束后向量不再改变,“苹果”永远一个向量。
优点:简单,查表即得;缺点:丢失多义信息,难以表达复杂语义。动态 / 语境化 Embedding(BERT, GPT 系列内部层):同一词在不同上下文里的向量不同。
优点:捕捉细腻歧义,语义准确;缺点:计算代价高,直接给句子打分需额外池化策略。
在当前的 RAG 场景中,最常用的是专门用对比学习训练的句嵌入模型。它们通常基于 BERT‑like 结构,通过“查询–正样本–负样本”三元组,让相关文本的向量拉近、不相关文本推远。
句嵌入模型的优点
- 直接输出高质量句/段向量,无需自己池化。
- 语义检索、聚类任务表现极强。
- 部分支持 Matryoshka 表示,可以灵活截断维度,平衡效果与开销。
句嵌入模型的缺点
- 需要 GPU 推理,模型体积较大(数百 MB 至 GB)。
- 对垂直领域的特殊术语若不微调,效果可能下降。
- 输入长度有限(如 512 或 8192 token),超长文档必须切片。
补充:到底有多少种 Embedding?
严格来说,Embedding 不是几种固定型号,而是一类技术范式。但站在应用视角,你经常打交道的其实有五类:
- 静态词嵌入(已基本被替代)
- 预训练语言模型取出的动态表示(BERT 等,需后处理)
- 专门训练的句嵌入模型(RAG 首选)
- 多模态对齐嵌入(CLIP 类)
- 商业 API 嵌入服务(OpenAI, Cohere 等)
6.3 选择 Embedding 模型时需要考虑什么
实际落地中,我们通常根据以下几点来选型:
- 任务场景:做搜索问答就用句嵌入模型,需要跨模态就用
CLIP。 - 语言支持:中文场景优先考虑 BGE、m3e 等中文优化模型。
- 推理成本:本地部署需 GPU 资源,API 调用则按 token 计费,需评估吞吐和延迟。
- 维度需求:高维度表达能力强,但存储和检索成本高。可优先选择支持
Matryoshka的模型,方便动态降维。 - 领域匹配:通用模型在医疗、法律等专业领域可能掉点,可通过少量领域数据微调来提升。
一个小建议:不要只看榜单(如 MTEB),最好用自己的真实业务数据做一次离线召回率测试,再上线 A/B 实验验证。
7. Embedding 的落地配套技术
有了 Embedding 向量,只是搭好了桥梁的桥墩。要让整座桥通车,还离不开以下这些“桥面”组件:
向量数据库(Chroma, Milvus, Pinecone, pgvector 等)
负责存储和快速检索海量向量。选择时需考虑:部署方式、查询速度、过滤能力。分块策略
文档怎么切,直接影响检索质量。块太大则语义杂糅,太小则丢失上下文。通常 256~512 token,配合 10%~20% 的重叠是常见起点。重排序模型
向量检索召回的 top‑k 结果,可以用更精准的交叉编码器再做一次排序,把最相关的块提到最前面,弥补 Embedding 模型的粗糙。缓存与更新机制
知识库更新后,对应的文本块必须重新 Embedding 并入库,否则会出现旧答案。需要设计增量索引和版本管理。